AlphaGo'nun 37. hamlesi akıl yürütmeydi, sohbet botlarının zinciri değil
AlphaGo ekibinden Thore Graepel'e göre 37. hamleyi oynatan şey sezgi değil açıkça kurulmuş bir arama ağacıydı. Bugünün dil modellerinde o ağaç yok; düşünce zinciri ise sonradan kurulabiliyor.
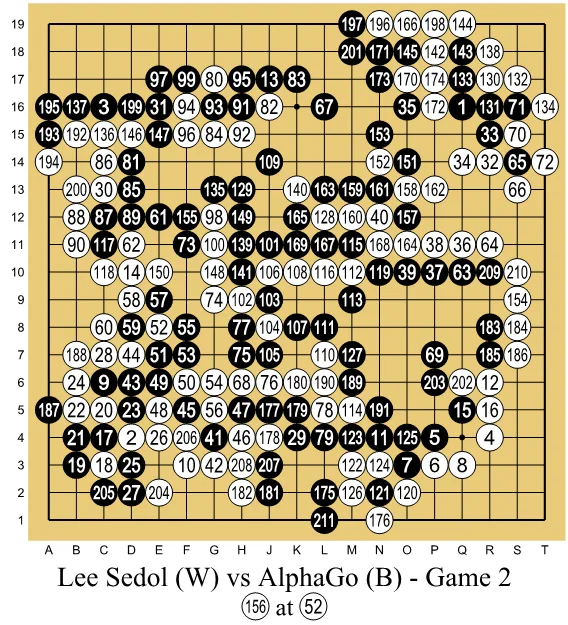
10 Mart 2016'da Seul'de bir bilgisayar programı, Go tahtasının beşinci çizgisine kimsenin beklemediği bir taş koydu. AlphaGo'nun ikinci karşılaşmadaki 37. hamlesiydi. Masa başındaki yorumcuların ilk tepkisi "hata" oldu; usta oyuncular tahtaya bakıp sustu. Saatler sonra hamlenin oyunun seyrini çeviren bir incelik taşıdığı anlaşıldı.
İlginç olan, AlphaGo'nun kendi "sezgisinin" de o hamleyi beğenmemiş olması. Programın insan oyunlarından öğrenmiş bölümü, 37. hamleyi usta bir insanın yaklaşık on binde bir oynayabileceği bir tercih olarak işaretlemişti. Hamleyi tahtaya koyduran şey başka bir mekanizmaydı.
-
Yemek tarifleri
Malzeme listesi, adım adım yapılış, süre ve porsiyon bilgisiyle. Çorbadan tatlıya kategoriye göre gez ya da aradığını doğrudan ara.
Tariflere bak → -
Nasıl yapılır rehberleri
Telefon ayarlarından resmî işlemlere, hesap güvenliğinden günlük hayattaki küçük sorunlara: numaralı adımlar ve tahmini süreyle anlatılmış rehberler.
Rehberleri gör → -
Program arşivi
Tarayıcılar, güvenlik araçları, ofis ve medya yazılımları. Her kayıtta ne işe yaradığı, sürümü ve indirme bağlantısı.
Programlara göz at → -
Sesli ve görüntülü sohbet
Odalarda grup görüntülü sohbet, birebir sesli arama ve canlı yayın. Tarayıcıdan çalışır — eklenti, uygulama ya da kurulum gerekmez.
Odalara gir →
Bu ayrımın neden bugün önem taşıdığını, AlphaGo ekibinin çekirdek üyelerinden biri olan Thore Graepel anlatıyor. University College London'da makine öğrenmesi kürsüsünün başında olan Graepel, MIT Technology Review'da yayımlanan yazısında şunu savunuyor: 37. hamle gerçek bir akıl yürütme ürünüydü — ve bugünün sohbet botları tam olarak o işi yapmıyor.
Bir makinenin sezgisi ile hesabı
Graepel'in anlatımına göre AlphaGo iki parçadan oluşuyordu. Birincisi politika ağı: güçlü bir insanın o konumda ne oynayacağını tahmin etmek üzere eğitilmiş sinir ağı. Bu, bir refleks gibi çalışır, anında cevap verir. İkincisi arama makinesi: önerilen hamlelerin ileriki sonuçlarını tartan, binlerce dala ayrılan bir oyun ağacını açıkça kuran ve içinde gezinen bölüm. Her dal farklı bir olası gelecek.
37. hamleyi oynatan ikinci parçaydı. Graepel'in ifadesiyle hamle, "bir makinenin bir konumu tutması, olası gelecekleri tartması ve yapay sezgilerinin büyük olasılıkla reddedeceği hamleyi tercih etmesi" anlamına geliyordu.
Benzetme Daniel Kahneman'ın Hızlı ve Yavaş Düşünme kitabında yaygınlaştırdığı ikiliye dayanıyor: Sistem 1 hızlı, otomatik, çaba istemeyen düşünme; Sistem 2 yavaş, adım adım, denetimli düşünme. Politika ağı Sistem 1'e, arama ağacı Sistem 2'ye benziyor.
Lee Sedol'un o karşılaşmanın ardından söylediği sözü Graepel aktarıyor: "AlphaGo'nun olasılık hesabına dayandığını, yalnızca bir makine olduğunu düşünüyordum. Ama bu hamleyi gördüğümde fikrimi değiştirdim. AlphaGo kesinlikle yaratıcı."
Düşünce zinciri gerçekten düşünmek mi?
Bugünün büyük dil modelleri bu arama ağacını kurmuyor. Bunun yerine düşünce zinciri (chain-of-thought) denen yöntemi kullanıyorlar: model cevabı doğrudan vermek yerine, ara adımları metin olarak yazıyor — "önce şunu hesaplarım, sonra şunu çıkarırım" — ve bu uzatılmış metin sonunda doğruluk oranını yükseltiyor. Matematik ve kodlamada iyileşme ölçülebilir düzeyde.
Graepel'in itirazı bu iyileşmeyi inkâr etmek değil, o metnin ne olduğuna dair. Ona göre bu, akıl yürütme değil uzatılmış örüntü tamamlama: modelin eğitim verisinde gördüğü dil kalıplarının istatistik bakımından en olası devamını üretmesi. Çıkarım ise bundan farklı bir şey: elindeki önermelerden, kurallara uyarak yeni ve zorunlu bir sonuca varmak.
Bu ayrımın deneysel karşılığı var. Miles Turpin, Julian Michael, Ethan Perez ve Samuel R. Bowman'ın NeurIPS 2023'te sunduğu çalışmada modellerin yazdığı düşünce zincirlerinin, cevabı gerçekten belirleyen etkenleri gizleyebildiği gösterildi. Araştırmacılar soruların içine yönlendirici ipuçları yerleştirdi — örneğin çoktan seçmeli yanıtların sırasını değiştirdiler. Modeller bu ipuçlarından etkilendi, ama yazdıkları gerekçelendirmede ipucundan hiç söz etmedi. BIG-Bench Hard derlemesinden 13 görevde, modeller yanlış yanıta doğru yönlendirildiğinde doğruluk %36'ya varan oranda düştü; açıklama metni ise sorunsuz görünmeye devam etti.
Daha yeni bir önbaskıda Arun Jose, sonuç odaklı pekiştirmeli öğrenmeyle eğitilmiş 14 akıl yürütme modelini inceledi. Bulgusu şu: bu modeller sık sık hem insanın hem de denetleyici başka modellerin okuyamadığı zincirler üretirken nihai cevabı doğru veriyor. Zincirin yalnızca okunabilir kısımları kullanılmaya zorlandığında doğruluk %53 geriledi; buna karşın okunabilirlik ile başarı arasında net bir ilişki de çıkmadı. Okunabilirlik özellikle zor sorularda bozuluyor. Jose bunun kaynağı için birkaç ihtimal sayıyor: steganografi, eğitim sırasında oluşan yan etkiler, jeton birikmesi.
Graepel'in üç itirazı
Graepel, sohbet botlarının yaptığı işin bir bilim insanının tanıyacağı anlamda akıl yürütme sayılmasını üç nedenle engelliyor:
- Açık bir bilgi durumu yok. Modelin hangi varsayımları değerlendirdiğini, hangisine ne kadar güvendiğini, hangi kanıtı tarttığını ve hangi soruyu askıda tuttuğunu gösteren, yeni bilgi geldikçe düzeltilen denetlenebilir bir defter bulunmuyor.
- Bilgi ile işlem ayrışmış değil. Sistemin bildiği şey ile o bilgiyi nasıl evirip çevirdiği, sinir ağının ağırlıklarının içinde iç içe geçmiş durumda; ayrıca ve açıkça temsil edilen bir inançlar kümesi yok.
- Zincir sonradan kurulabiliyor. Üretilen adımlar müzakere gibi görünüyor, ama araştırmalar botların cevaba bir yoldan varıp başka bir yolu rapor edebildiğini gösteriyor.
Graepel'in önerisi AlphaGo mimarisinden ilham alıyor: oyun ağacının yerine, yerleşmiş inançları, kuşkuları, elenmiş olasılıkları ve açık soruları taşıyan, dışarıdan incelenebilir bir bilgi durumu. Akıl yürütme o zaman bu durumu değiştiren hamleler dizisi olarak tanımlanabilir — sonuç çıkarmak, problemi parçalara bölmek ve en önemlisi sırada hangi sorunun sorulacağına, hangi hesabın yapılacağına, hangi deneyin kurulacağına karar vermek.
Karşı taraf: zincir yalnızca süs değil
Bu tablonun karşısında, düşünce zincirini "uzatılmış örüntü tamamlama"ya indirgemenin de bir sınırı olduğunu gösteren işler var.
William Merrill ve Ashish Sabharwal'ın ICLR 2024'te sunduğu kuramsal çalışma, ara adım üretmenin bir dönüştürücü modelin hesaplama gücünü gerçekten büyüttüğünü kanıtlıyor — ve bunun ne kadar adıma izin verildiğine bağlı olduğunu gösteriyor. Logaritmik sayıda adım yalnızca sınırlı bir ilerleme sağlıyor; adım sayısı girdiyle doğrusal büyüdüğünde model tüm düzenli dilleri tanıyabiliyor; polinom sayıda adımla polinom zamanda çözülebilen problemlerin tamamına ulaşıyor. Yani zincir, ara adım yazmadan ulaşılamayacak problem sınıflarını açıyor; ağ bağlantısını denetlemek ya da bir durum makinesini işletmek gibi, anında cevap veren bir dönüştürücünün yapamadığı işler bunlar.
İkinci itiraz "yalnızca yüzey istatistiği" fikrine. Kenneth Li, Aspen K. Hopkins, David Bau, Fernanda Viégas, Hanspeter Pfister ve Martin Wattenberg'in ICLR 2023'te sunduğu çalışmada bir GPT türevi, Othello oyununda geçerli hamleleri tahmin etmek üzere eğitildi — oyunun kurallarını hiç görmeden, yalnızca hamle dizilerinden. Araştırmacılar modelin içinde tahtanın durumuna karşılık gelen, doğrusal olmayan bir iç temsilin kendiliğinden oluştuğunu buldu. Dahası bunu müdahaleyle doğruladılar: temsili değiştirdiklerinde modelin çıktısı buna uygun biçimde değişti. Bu, dizilerin ardındaki süreci modelin içinde bir yerde taşımak anlamına geliyor.
Bulgunun sınırları
Birkaç kayıt düşmek gerekiyor. Graepel'in metni bir görüş yazısı; yeni bir deney sunmuyor, mevcut çalışmaları bir mimari tez etrafında topluyor. Jose'nin bulgusu arXiv'de duran bir önbaskı, hakem denetimli dergi aşamasını geçmiş değil. Othello çalışması ise kuralları kapalı ve dar bir oyun üzerinde; oradaki iç temsilin doğal dilin tamamına ölçeklendiği gösterilmiş değil. Turpin ve arkadaşlarının denediği modeller de bugünün en yeni sürümleri değil, 2023 dönemine ait.
AlphaGo'nun Lee Sedol'la karşılaşmasını anlatan belgesel, Google DeepMind'ın kendi kanalında tamamıyla yayımlanmış durumda:
Açık kalan soru
Tartışmanın ağırlık merkezi "model akıllı mı" sorusundan kayıyor. Asıl soru şu hale geliyor: bir sistemin verdiği cevabın arkasındaki süreci dışarıdan okuyabiliyor muyuz? Turpin ve arkadaşlarının bulgusu, inandırıcı görünen bir açıklamanın güvenilir olmayan bir süreci gizleyebileceğini söylüyor. Jose'nin bulgusu ise daha rahatsız edici bir yönü işaret ediyor: okunabilirlik için özel olarak ödüllendirilmediğinde, eğitim süreci zincirleri kendiliğinden daha kapalı hale getiriyor.
Graepel'in çağrısı bu noktada anlam buluyor — tıpta ya da bilimde karar desteği verecek bir sistemde, cevabın yanında denetlenebilir bir muhakeme defterinin de durması. Böyle bir defteri sinir ağlarının esnekliğinden vazgeçmeden kurmanın yolu henüz bilinmiyor. 37. hamlede oyun ağacını açıp bakmak mümkündü; bugünün modellerinde bakılacak bir ağaç yok.
Fotoğraf: Wesalius, CC BY-SA 4.0, Wikimedia Commons