Bütün şirketler aynı algoritmayı kullanırsa işe alım nasıl değişir
MIT'den Brian Hedden ve Manish Raghavan, birçok şirketin aynı işe alım algoritmasını kullandığı düzeni modelledi. Tektipleşmeye yöneltilen itirazların çoğu modelde tutmadı; ayakta kalan tek itiraz keşfin daralması oldu.
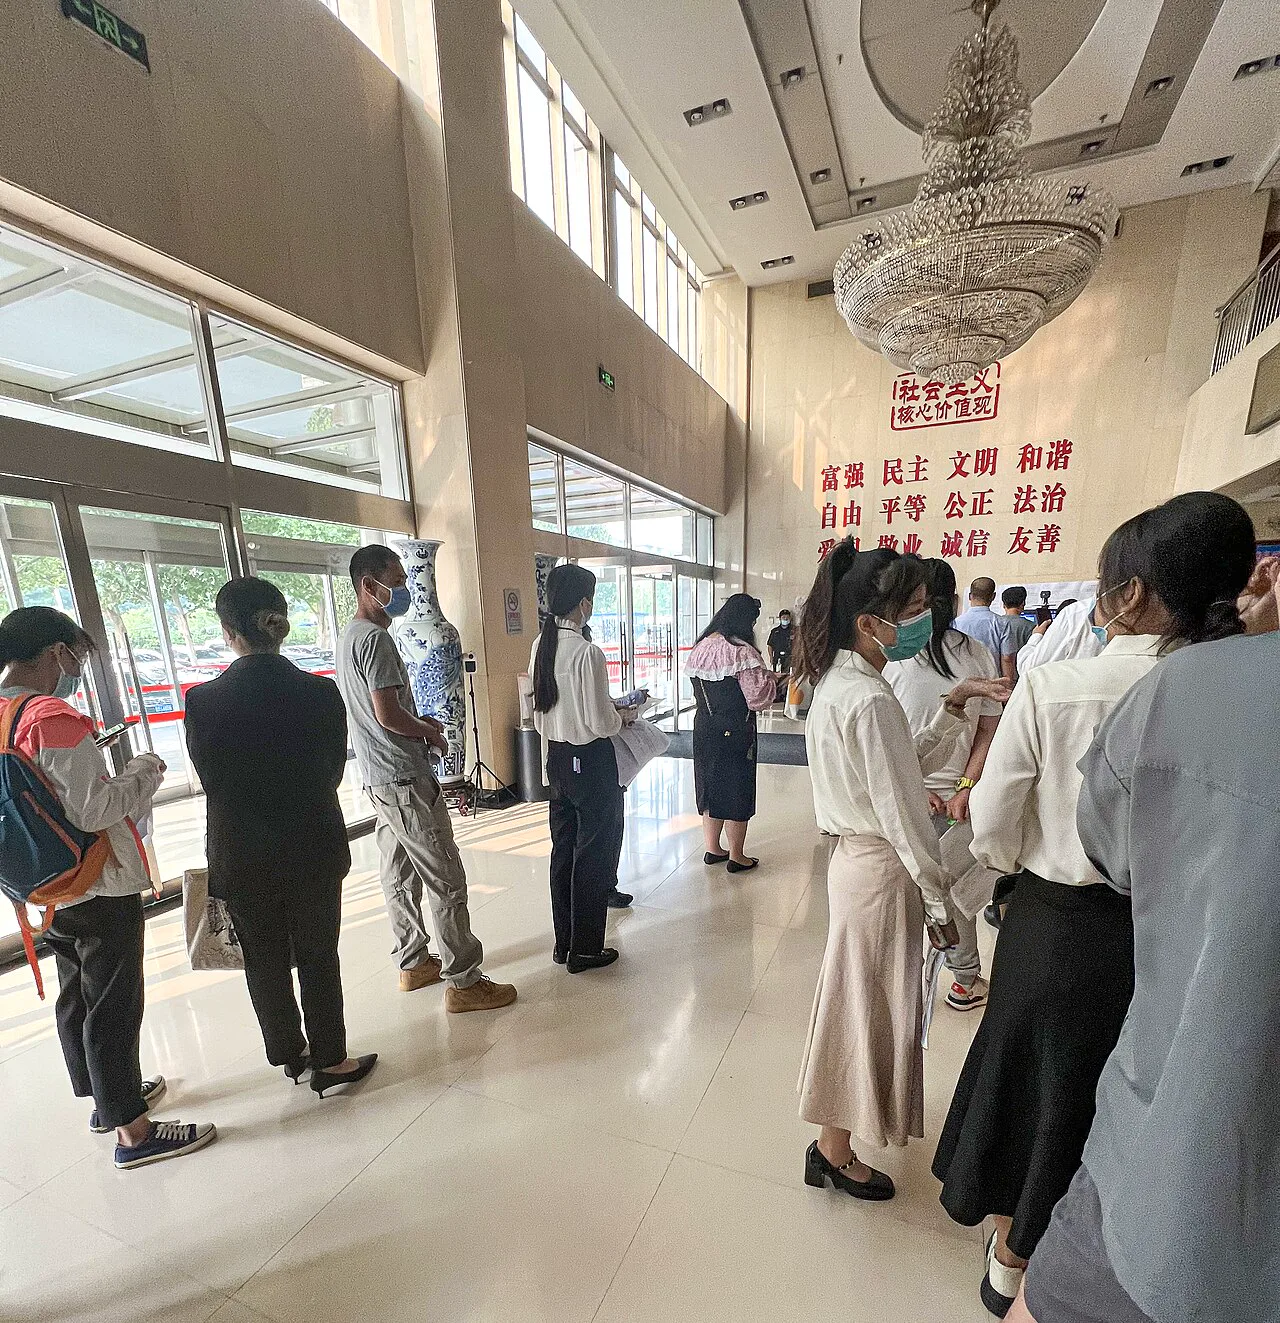
On beş hektarlık bir buğday tarlasında tek bir gelincik. Chris Reynolds'un 2009'da İngiltere'de çektiği bu kare, tarımdaki "monokültür" kelimesinin en kısa tarifi: tek tür, tek sıra, tek davranış. Bilgisayar bilimciler birkaç yıldır aynı kelimeyi bambaşka bir tarla için kullanıyor — iş başvurusu tarlası.
Algoritmik tektipleşme (İngilizcesi algorithmic monoculture), bir alandaki bütün kararların tek ve ortak bir algoritmayla verilmesi demek. İşe alımdaki karşılığı şu: yüzlerce şirket, aynı satıcıdan aldığı ya da aynı modele dayanan aynı özgeçmiş ayıklama yazılımını çalıştırıyor. Endişe ilk bakışta çok mantıklı: yazılım bir adayı beğenmiyorsa o aday bütün kapılardan aynı anda döner, üstelik nedenini hiçbir yerde öğrenemez.
-
Yemek tarifleri
Malzeme listesi, adım adım yapılış, süre ve porsiyon bilgisiyle. Çorbadan tatlıya kategoriye göre gez ya da aradığını doğrudan ara.
Tariflere bak → -
Nasıl yapılır rehberleri
Telefon ayarlarından resmî işlemlere, hesap güvenliğinden günlük hayattaki küçük sorunlara: numaralı adımlar ve tahmini süreyle anlatılmış rehberler.
Rehberleri gör → -
Program arşivi
Tarayıcılar, güvenlik araçları, ofis ve medya yazılımları. Her kayıtta ne işe yaradığı, sürümü ve indirme bağlantısı.
Programlara göz at → -
Sesli ve görüntülü sohbet
Odalarda grup görüntülü sohbet, birebir sesli arama ve canlı yayın. Tarayıcıdan çalışır — eklenti, uygulama ya da kurulum gerekmez.
Odalara gir →
MIT'den iki araştırmacı bu endişeyi maddeler halinde ayırıp hesaba döktü. Çıkan sonuç, beklenenin tersi yönde: itirazların çoğu modelde ayakta kalmıyor, ayakta kalan tek itiraz da aslında bambaşka bir şey.
Uyarı 2021'de gelmişti
Tartışmayı başlatan çalışma, Jon Kleinberg ile Manish Raghavan'ın 2021'de PNAS'ta yayımladığı "Algorithmic monoculture and social welfare" makalesi. İkili orada şunu gösterdi: iki şirket kendi el yordamı yöntemleriyle karar verirken, daha isabetli olan ortak bir algoritmaya geçmek her biri için tek başına akıllıcadır; ama ikisi birden geçtiğinde toplamda verilen kararların ortalama kalitesi düşebilir. Kleinberg ve Raghavan'a göre bunun için dışarıdan bir şok da gerekmiyor, sistem gayet normal işlerken de olabiliyor.
Buradaki mantık, bir sınavda herkesin aynı cevap anahtarını kullanmasına benziyor. Anahtar tek başına iyi olabilir; ama anahtar bir soruda yanılıyorsa, artık hiç kimse o soruyu doğru yapmaz. Farklı anahtarlar kullanılsaydı, birinin hatasını bir diğeri kapatabilirdi.
Yeni makale: itirazları teker teker sınamak
MIT'nin 29 Eylül 2026'da duyurduğu yeni çalışma, aynı Manish Raghavan'ın — bu kez MIT Sloan İşletme Okulu'nda, Drew Houston kürsüsünde — Dilbilim ve Felsefe Bölümü'nden Brian Hedden ile birlikte yazdığı "Algorithmic Monoculture and its Critics" makalesi. Philosophical Perspectives dergisinde çıktı, ön baskısı arXiv'de herkese açık.
Yöntem konusunda baştan net olmakta fayda var: bu bir saha araştırması değil. Gerçek başvurular, gerçek şirketler, gerçek yazılımlar incelenmiş değil. Yazarlar matematik modelleri kurup bilgisayar benzetimleri çalıştırdı. Makaledeki benzetimlerin kurulumu şöyle:
| Her koşudaki aday sayısı | 1.000 |
|---|---|
| Adayın "gerçek" değeri | Ortalama 0, standart sapma 1 olan normal dağılımdan çekiliyor |
| Şirketlerin gördüğü | Bu değerin gürültülü, yani hatalı bir tahmini |
| Kurgu 1 — sıralı | Şirketler rastgele sırayla geliyor, her biri kalanların en iyisini işe alıyor |
| Kurgu 2 — eşzamanlı | Her şirkette 10 iş, adayların şirket tercihleri rastgele; eşleştirme Gale ve Shapley'nin 1962 tarihli ertelenmiş kabul algoritmasıyla |
| Karşılaştırılan iki düzen | Tektipleşme (tek ortak algoritma) ve çeşitlilik (her şirkete ayrı algoritma) |
Tablodaki bilgiler makalenin kendi metninden. Hedden ve Raghavan benzetim kodunu da açık bıraktı.
Birinci itiraz: "hep aynı kişiler dışarıda kalır"
En yaygın itiraz bu ve yazarlar ikna edici bulmuyor. İki gerekçe sunuyorlar:
- Sıralı işe alımda bir şirketten dönmek bütün şirketlerden dönmek değildir. Birinci şirkette ikinci sırada kalan aday, o şirket birinciyi aldıktan sonra ikinci şirketin listesinin başına geçer. Şirketlerin önündeki havuzlar aynı değil, çünkü her işe alma havuzu bir kişi eksiltiyor.
- İş sayısı ve aday sayısı sabitken, işsiz kalan kişi sayısı iki düzende de birebir aynı. Hedden ve Raghavan bu noktada Kenny Peng ve Nikhil Garg'ın 2024 tarihli çalışmasına dayanıyor.
Peki hangi grubun dışarıda kalacağı? Algoritmalar hakkında hiçbir bilgimizin olmadığını varsayarsak — yazarların felsefeden ödünç aldığı "bilgisizlik peçesi" kurgusu — her aday kümesinin açıkta kalma olasılığı iki düzende de eşit çıkıyor. Makale burada bir hesap örneği veriyor: 100 adayın onar kişilik 10 gruba ayrıldığı bir kurguda, belli bir 10 kişilik grubun tamamen işsiz kalma olasılığı, 100 kişiden 10 kişinin kaç farklı biçimde ayrılabileceğine bölünmüş bir sayı; ve bu olasılık tektipleşmede de çeşitlilikte de aynı.
Raghavan ters yönde bir etkiye de dikkat çekiyor. MIT'nin duyurusunda kullandığı ifadeyle: "Bütün işler doluyor ve aynı sayıda insan iş sahibi oluyor, ama şirketler aynı aday havuzu için birbiriyle yarışıyor, bu da ücretleri yukarı itiyor." Mantık basit: bütün teklifler aynı az sayıda kişiye giderse, o kişilerin pazarlık gücü artar. Yazarlar burada kendi kendilerini frenliyor; makalede son dönem iktisat yazınının çoklu teklifin ücrete etkisi konusunda hemfikir olmadığı ayrıca belirtiliyor.
İkinci itiraz: kendi çabanın karşılığı
İkinci endişe kişinin kendi üzerindeki denetimiyle ilgili ve iki ucu var. Bir uçta şu var: bir işten dönersen, eksiğini görür, başvuru dosyanı düzeltir, mülakat pratiği yapar ve bir sonraki kapıda şansını artırırsın. Katı bir tektipleşmede — puanın bir kez verilip bütün şirketlere iletildiği bir merkezî platform düşünün — bu öğrenme döngüsü kapanır.
Öteki uçta tam tersi var: parçalı bir sistemde her kapıya ayrı bir numara yapabilirsin, yani sistemi oyunlayabilirsin, ve bunu yapacak zamanı ile parası olan aday öne geçer. Hedden ve Raghavan'ın sonucu ortada: itiraz ancak çok katı bir tektipleşme kurgusunda tutuyor. Adayın dosyasını gözden geçirip yeniden başvurabildiği daha gevşek bir düzende öğrenme kapısı kapanmıyor, dolayısıyla itiraz gücünü yitiriyor.
Üçüncü itiraz: yankı odası
Yazarların "en ikna edici" dediği itiraz bilgiyle ilgili ve ikiye ayrılıyor.
Birincisi kalabalığın bilgeliği: birbirinden bağımsız ve benzer isabetlilikte birçok algoritma varsa, hepsinin tahmini ortalandığında tekil bir algoritmadan daha iyi bir sonuç çıkar. Bu klasik istatistik; gürültülü ölçümleri toplamak gürültüyü azaltır. Makale bu noktada tektipleşmenin gerçekten geride kaldığını kabul ediyor.
İkincisi keşif. Bilgisayar bilimlerinde "çok kollu haydut" (multi-armed bandit) denen kurgu var: adı tek kollu kumar makinelerinden geliyor, elinizde ödülü bilinmeyen birkaç kol var ve iyi bildiğiniz kolu çekmekle (sömürü) hiç denemediğiniz kolu denemek (keşif) arasında bölünüyorsunuz. İşe alımda karşılığı: bilinen okuldan, bilinen sektörden, bilinen profilden adamı almak mı, yoksa hakkında az şey bilinen bir adayı denemek mi? Herkes aynı puanlamaya bakıyorsa, herkes aynı "bilinen"e yönelir ve kimse alışılmadık profili denemez. Yankı odası tam olarak bu.
Ama makalenin ilginç kısmı burada başlıyor. Hedden ve Raghavan, keşif teoreminin işe alımı iyi modellemediğini söylüyor: bir adayı aynı anda birden fazla şirket işe alamaz. Şirketler adayları aynı sırada beğenseler bile, biri hariç hepsi listede aşağı inmek zorunda. Yani işe alımda bir şirketin kararı diğerlerinin önündeki seçenekleri değiştiriyor — iktisatta buna dışsallık deniyor. İşsizlik oranı sabitse, her turda aynı sayıda kişi işe alınıyor, dolayısıyla aynı sayıda kişi "denenmiş" oluyor. İşe alım pazarının yapısı, kimse istemese bile bir miktar keşfi zorunlu kılıyor.
Tek algoritma daha iyi olabilir mi
Makalenin en ters köşe önerisi bu. Diyelim ki çeşitlilik düzeninde on ayrı şirketin on ayrı algoritması var. Bunları tek bir topluluk (ensemble) algoritmasında birleştirip herkese o tek algoritmayı verirseniz, ortaya gene bir tektipleşme çıkar — ama bilgisi zenginleşmiş bir tektipleşme. Yazarların benzetimlerinde bu birleşik düzen, kendisini oluşturan çeşitlilik düzeninden daha iyi sonuç veriyor.
Nedeni şu: çeşitlilikte on algoritmanın topladığı bilginin her kararda yalnız küçük bir parçası kullanılıyor. Toplulukta ise bilgi havuzlanıyor ve her kararda hepsi birden devreye giriyor. Peng ve Garg'ın teoremine dayanarak yazarlar şunu da ekliyor: birleştirilen algoritma sayısı arttıkça, böyle bir düzenin yalnızca en iyi adayları işe alma olasılığı 1'e yaklaşıyor.
Yani sorun "tek algoritma" olması değil; o tek algoritmanın ne kadar bilgi topladığı. Tarla benzetmesine dönersek: mesele tarlanın tek tür olması değil, o türün içinde kaç farklı damarın bulunduğu.
Bu çalışma neyi söylemiyor
Makale kendi sınırlarını açıkça yazıyor ve bunları atlamamak gerek:
- Bütün kurgu, adayların tek bir nesnel sıralaması olduğu varsayımına dayanıyor. Gerçek hayatta "iyi aday" işe ve ekibe göre değişir.
- Kalabalığın bilgeliği argümanı algoritmaların hatalarının birbirinden bağımsız olmasını gerektiriyor. Yazarlar bunun gerçekte pek olası olmadığını kabul ediyor: modeller çakışan verilerle eğitiliyor ve benzer özniteliklere bakıyor.
- Analiz işe alıma odaklı. Sağlık ve kredi gibi alanlarda yapı farklı; oralarda bir kişiyi "işe almak" başkasının önünden almak anlamına gelmiyor, yani keşfi zorlayan dışsallık yok.
- Topluluk algoritması kurmanın pratikte mümkün olup olmadığı incelenmemiş. Yazarların kendi cümlesiyle, böyle bir birleştirme "uygulanabilir olmayabilir" — çünkü ayrı ayrı veri toplama ve model kurma maliyetini yeniden üstlenmeyi gerektirir.
- Gerçek iş pazarındaki sürtünmeler modelde yok: ilanların farklı zamanlarda çıkması, adayların her yere başvurmaması, sürecin aylar sürmesi.
Kısacası bu bir düşünce deneyleri ve hesap zinciri; bir saha ölçümü değil. Hedden'in MIT duyurusundaki ifadesi de bu yönde: "Algoritmik tektipleşmeye dair vaatlerin ve tuzakların yanıtlarının çoğu bağlama bağlı olacak."
Sırada ne var
Konunun formel tarafında iş sürüyor. Robert Kleinberg, Erald Sinanaj ve Éva Tardos'un Nisan 2026'da paylaştığı bir çalışma, Kleinberg ve Raghavan'ın modelini genelleştirip şirketler stratejik davrandığında refah kaybının ne kadar olabileceğini ölçüyor: "anarşinin bedeli" denen oran en fazla iki çıkıyor, yani herkesin kendi çıkarına davrandığı bir düzenin toplam sonucu, merkezî en iyi düzenin yarısından kötü olamıyor. Patolojik örnekler dışında fark bundan çok daha küçük.
Asıl boşluk ampirik tarafta. Bugün hiç kimse, gerçek iş pazarında kaç şirketin fiilen aynı ayıklama modeline dayandığını kamuya açık biçimde bilmiyor; yazılım satıcıları da bunu paylaşmıyor. Tektipleşmenin ne kadar ilerlediği ölçülmeden, onun iyi mi kötü mü olduğu sorusu masa başında kalmaya devam edecek. Şimdilik elimizde olan şu: sezgi "kötü bir şey" diyordu, hesap "duruma bağlı" diyor.
Fotoğraf: N509FZ, CC BY-SA 4.0, Wikimedia Commons