Yerel Yapay Zeka İş İstasyonu, Bulut Maliyetlerini Geride Bırakıyor
İki AMD Radeon AI PRO R9700 ekran kartı ve 18.775 dolarlık donanımla kurulan yerel yapay zeka sistemi, yüksek hacimli işlemlerde GPT‑5.6 Sol ve Claude Opus 5 gibi bulut modellerinin API maliyetlerinin altına inerek yılda binlerce dolar tasarruf sağlıyor.
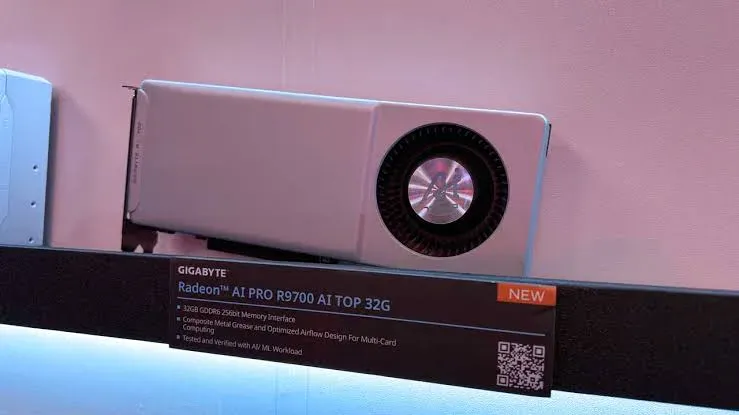
Yapay zeka uygulamalarının bulut üzerinden çalıştırılması, özellikle yüksek hacimli token üretimi gerektiren senaryolarda maliyet açısından giderek zorlayıcı bir hâl alıyor. Technopat'ın 14 Eylül 2026 tarihli haberine göre, iki adet AMD Radeon AI PRO R9700 ekran kartı ve 18.775 dolarlık bir iş istasyonu, aynı iş yüklerini bulut hizmetleriyle karşılaştırıldığında çok daha ekonomik bir alternatif sunuyor.
Test ortamı, iki Radeon AI PRO R9700 kartının toplam 64 GB GDDR6 VRAM sağladığı bir yapı üzerine kuruldu. İş istasyonunda AMD Ryzen Threadripper PRO işlemci, 128 GB RAM ve profesyonel sınıf bir anakart bulunuyor; kartların tek başına maliyeti ise yaklaşık 3.760 dolar. Bu donanım, Qwen3.6‑27B modelini çalıştırarak standart vLLM FP8 Tensor Parallelism yapılandırmasında sekiz eş zamanlı kullanıcı altında saniyede 156,2 token üretirken, Multi‑Token Prediction (MTP) etkinleştirildiğinde aynı koşullarda saniyede 320,2 token üretim seviyesine ulaşıyor.
-
Yemek tarifleri
Malzeme listesi, adım adım yapılış, süre ve porsiyon bilgisiyle. Çorbadan tatlıya kategoriye göre gez ya da aradığını doğrudan ara.
Tariflere bak → -
Nasıl yapılır rehberleri
Telefon ayarlarından resmî işlemlere, hesap güvenliğinden günlük hayattaki küçük sorunlara: numaralı adımlar ve tahmini süreyle anlatılmış rehberler.
Rehberleri gör → -
Program arşivi
Tarayıcılar, güvenlik araçları, ofis ve medya yazılımları. Her kayıtta ne işe yaradığı, sürümü ve indirme bağlantısı.
Programlara göz at → -
Sesli ve görüntülü sohbet
Odalarda grup görüntülü sohbet, birebir sesli arama ve canlı yayın. Tarayıcıdan çalışır — eklenti, uygulama ya da kurulum gerekmez.
Odalara gir →
MTP’nin tek kullanıcı performansı saniyede 62,75 token, dört eş zamanlı kullanıcıda 186,29 token ve sekiz eş zamanlı kullanıcıda 320,23 token olarak ölçüldü. Bu yoğun kullanımda iki ekran kartının toplam güç tüketimi yaklaşık 490 watt, standart vLLM yapılandırmasında ise 480 watt olarak kaydedildi. Sistem dışı bileşenler (işlemci, RAM, depolama, fanlar ve güç kaynağı kayıpları) için ek 300 wattlık bir tüketim varsayımı yapıldı.
Ekonomik analiz, donanım maliyeti, üç yıllık kullanım süresi, elektrik fiyatı (kWh başına 0,1354 dolar) ve üretilen token miktarını bir araya getiriyor. Bulut tarafında ise bir milyon çıktı tokenı için GPT‑5.6 Sol 30 dolar, Claude Opus 5 25 dolar, Gemini 3.1 Pro ve GPT‑5.6 Terra 12 dolar, Claude Sonnet 5 ise 10 dolar olarak hesaplanmış. Daha düşük fiyatlı bulut seçenekleri arasında Gemini 3.6 Flash 7,50 dolar, Claude Haiku 5 5 dolar, Gemini 3.1 Flash‑Lite 1,50 dolar ve GPT‑5.6 Luna 1,20 dolar bulunuyor.
Bu rakamlar ışığında, MTP aktif çift R9700 sistemi sekiz kullanıcıyı sürekli yük altında tutarak haftada sadece 3,5 saat çalıştırıldığında GPT‑5.6 Sol’un token maliyetinin altına iniyor. Claude Opus 5 karşısında 4,2 saat, Gemini 3.1 Pro ve GPT‑5.6 Terra karşısında 8,8 saat, Claude Sonnet 5 karşısında ise 10,5 saatlik çalışma süresi yeterli oluyor. Daha ucuz bulut modelleri için ise Gemini 3.1 Flash‑Lite karşısında haftada 74,2 saat, GPT‑5.6 Luna karşısında 94,3 saatlik kullanım gerekir. Bir haftada toplam 168 saat bulunması, yerel sistemin uzun vadede ciddi bir tasarruf sağlayabileceğini gösteriyor.
Sonuç olarak, yüksek performanslı GPU’lar ve uygun bir donanım altyapısıyla kurulan yerel yapay zeka iş istasyonları, özellikle yoğun token üretimi gerektiren uygulamalarda bulut hizmetlerinin maliyetini geride bırakıyor. Bu bulgu, şirketlerin ve araştırma kurumlarının yapay zeka altyapılarını yeniden değerlendirmeleri ve uzun vadeli maliyet avantajı elde etmeleri için önemli bir referans noktası sunuyor.