Başkasının aksanını kapmak elimizde mi? 136 kişilik deney: Büyük ölçüde evet
Ohio State dilbilimcileri Amerikalılara Avustralyalı bir sesi tekrar ettirdi: Taklit isteyen aksanı yakaladı, istemeyen hiç kapmadı. Talimatsız kalanlar ise yalnız fark ettikleri sesi kopyaladı.
Yıllardır büyük şehirde yaşayan biri bayramda memlekete gider. Otogarda karşılayan akrabasıyla iki cümle konuşmadan, çoktandır kullanmadığı ezgiler, uzattığı heceler, yuttuğu sesler geri gelir. Dönüşte birkaç gün daha o ağızla konuşur, sonra yavaş yavaş eski hâline döner. Bu sahneyi çoğumuz ya yaşamışızdır ya da bir yakınımızda görmüşüzdür; genelde de aynı açıklamayla geçiştiririz: Şive bulaşıcıdır, insanın elinde değildir.
Ohio State Üniversitesi'nden iki dilbilimcinin Laboratory Phonology dergisinde yayımlanan çalışması bu "elinde değildir" kısmını sorguluyor. Kathryn Campbell-Kibler ile Cynthia Clopper, 136 Amerikalı gönüllüye Avustralyalı bir kadının okuduğu kelimeleri dinletip tekrar ettirdi. Taklit etmeleri istenenler aksanı kolayca yakaladı; taklit etmemeleri istenenler kendi konuşmalarından hiç ayrılmadı. Hiçbir şey söylenmeyenler ise tek bir özelliği kaptı: Avustralyalının kelime sonunda yuttuğu "r" sesini.
Sonuç önemli, çünkü dilbilimde uzun süre bu tür laboratuvar taklidi, duyulan sesin konuşmaya kendiliğinden geçtiği otomatik bir refleks olarak görüldü. Yeni deney, taklidin büyük bölümünün denetim altında olduğunu, denetimin kaçtığı yerde de belirleyici olanın insanın neyi "fark ettiği" olduğunu gösteriyor.
Konuşma uyumu: Karşımızdakine benzeme eğilimi
Dilbilimciler, konuşurken karşımızdakinin sesine, hızına, telaffuzuna doğru kaymamıza fonetik yakınsama (İngilizcede phonetic convergence) diyor. Yani iki kişinin sesleri, bir sohbet boyunca birbirine doğru yaklaşıyor. Bunun tersi de var: İnsan bazen kendini karşısındakinden ayırmak için farkı bilerek büyütür; buna da ıraksama (divergence) deniyor.
Bu iki davranışı toplumsal bir çerçeveye oturtan yaklaşım iletişim uyumu kuramı (Communication Accommodation Theory). Kuramın temelleri 1970'lerde sosyal psikologlar Howard Giles ile meslektaşları Taylor ve Bourhis tarafından, o zamanki adıyla "konuşma uyumu kuramı" olarak atıldı. Ana fikir şu: Konuşmamızı karşımızdakine yaklaştırmak ya da ondan uzaklaştırmak, yakınlık kurmanın veya mesafe koymanın bir yolu.
Ancak işin bir de laboratuvar tarafı var. Araştırmacılar yıllardır "gölgeleme" (shadowing) denen bir yöntem kullanıyor: Katılımcı kulaklıktan bir kelime duyuyor ve hemen ardından kendisi söylüyor. Ortada sohbet edilecek, hoşa gidilecek kimse yok. Buna rağmen insanlar duydukları sese benzemeye başlıyor. Bu yüzden laboratuvar taklidi, algıyla konuşma arasındaki sıkı bağdan doğan otomatik bir süreç olarak yorumlandı. Campbell-Kibler'in 2015'te dilbilimci Walker ile birlikte yürüttüğü önceki bir çalışmada katılımcıların bir kısmı, taklit etmemeleri açıkça söylendiği hâlde konuşmacıya benzemişti.
Bilim müzesinde bir ses deneyi
Yeni deney, Ohio State'in Columbus'taki bilim müzesi COSI'nin içinde işlettiği dil bilimleri araştırma laboratuvarında yapıldı. Müze ziyaretçileri arasından 236 kişi katıldı; konuşma ya da işitme sorunu bildirenler, anketi tamamlamayanlar ve kaydı bozulanlar çıkarıldıktan sonra 136 kişinin verisi analize girdi. Katılımcıların yaş ortalaması 33'tü.
Dinletilen ses, Batı Avustralya'nın başkenti Perth'ten, yirmili yaşlarında, üniversite mezunu bir kadına aitti. Kayıtlar 2015 çalışmasından alınmıştı. Deney iki aşamalıydı:
- Taban ölçüm: Katılımcılar ekranda beliren kelimeleri hiçbir ses duymadan, kendi doğal telaffuzlarıyla okudu.
- Gölgeleme: Aynı kelimeler bu kez Avustralyalı konuşmacının sesiyle birlikte geldi; katılımcılar duyduklarını tekrar etti.
Gruplar arasındaki tek fark ikinci aşamadaki talimattı. Bir grup yalnızca "duyduktan sonra kelimeyi söyleyin" sözünü aldı. İkinci gruba "konuşmacıyı olabildiğince yakından taklit etmeye çalışın" dendi. Üçüncü gruptan ise "kelimeyi onun söylediği gibi değil, normalde nasıl söylüyorsanız öyle söyleyin" istendi.
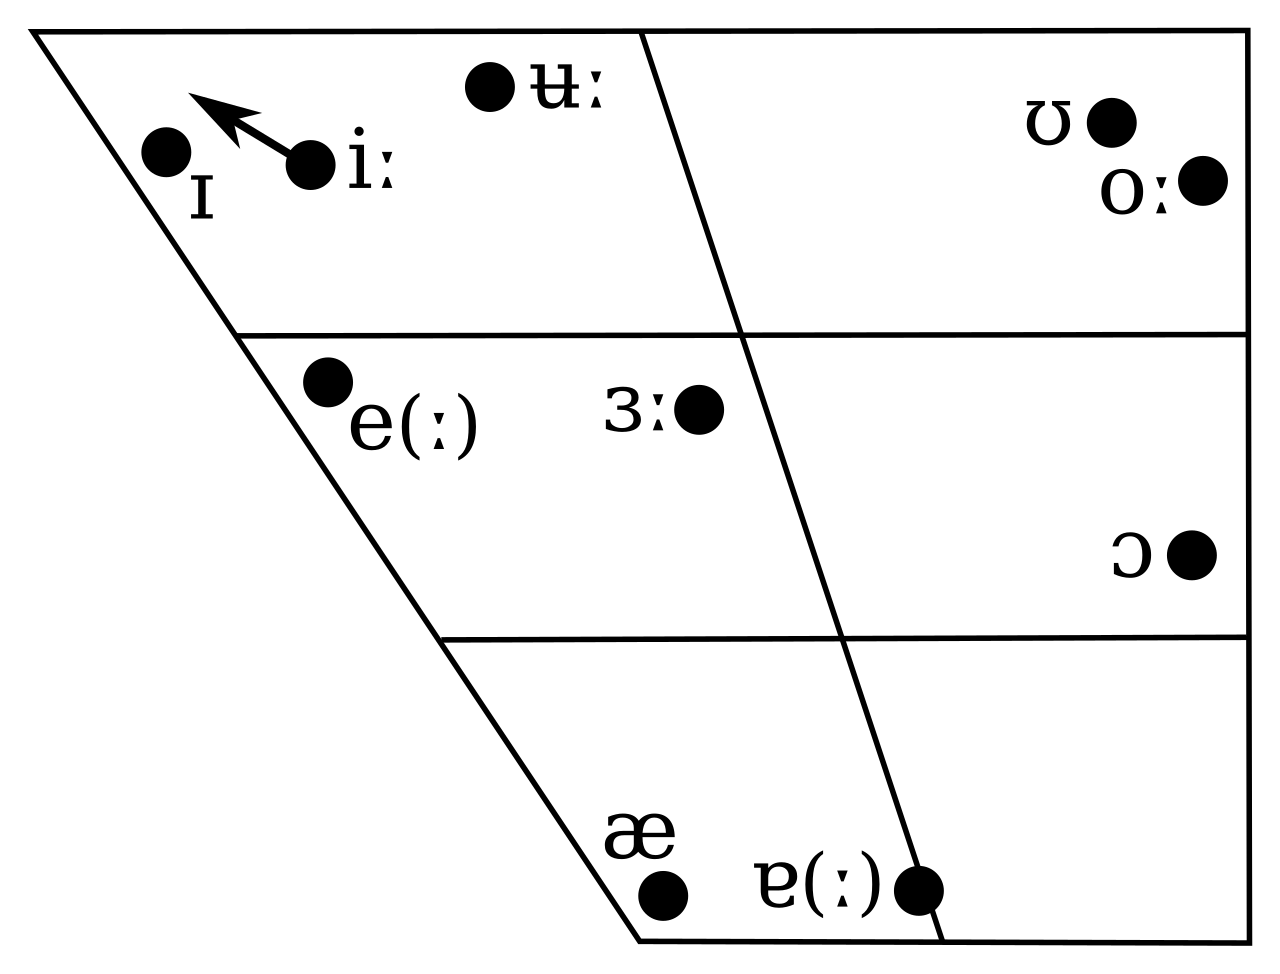
Araştırmacılar beş ses grubuna baktı; İngilizcede bu gruplar örnek bir kelimeyle anılıyor: bath, trap, kit, price ve near. Her gruptan sekiz kelime kullanıldı. Avustralya İngilizcesiyle Amerikan İngilizcesi bu seslerde birbirinden ayrılıyor. Örneğin bu konuşmacı bath türü kelimelerdeki "a"yı ağzın daha gerisinde, "baath" gibi söylüyor; near kelimesinin sonundaki "r"yi ise neredeyse hiç söylemiyor. Ölçüm, ses kaydındaki formantlar üzerinden yapıldı. Formantlar, bir ünlüyü söylerken ağız içinin şekline göre güçlenen ses frekansları; dilin ağızda ne kadar yukarıda ve ne kadar önde durduğunu sayısal olarak yakalamaya yarıyor. "r" sesinin varlığı da yine bu frekansların aralığından ölçülüyor.
Sonuç: Talimat neyse o oldu
Üç grubun ikinci aşamada taban ölçüme göre nasıl değiştiği, makaledeki istatistik analizine göre şöyle özetlenebilir:
| Grup | Kişi | Ne oldu? |
|---|---|---|
| Taklit et | 42 | Beş ses grubunun hepsinde konuşmacıya yaklaştılar; en güçlü kayma "r"siz near ve geride söylenen bath seslerinde |
| Taklit etme | 51 | Hiçbir seste yaklaşma görülmedi; kit sesinde tersine konuşmacıdan uzaklaştılar |
| Talimat yok | 43 | Yalnızca near kelimesindeki "r" düşmesini kaptılar; diğer dört seste anlamlı değişiklik yok |
Campbell-Kibler, üniversitenin duyurusunda bulguyu şöyle özetliyor: "İnsanlar, istenirse birine benzeyip benzememeyi oldukça iyi denetleyebiliyor; ama toplumsal olarak anlamlı ve dikkat çekici buldukları aksan özellikleri buna karışıyor." Ve ekliyor: "Kısacası, birini taklit edip etmeyeceğinizi söylemezsek, onun fark ettiğiniz ya da ilginç bulduğunuz yanlarına benzemeye başlıyorsunuz."
Kapılan ses, fark edilen ses
Deneyden sonra katılımcılara bir anket verildi ve konuşmacının söyleyişinde özellikle dikkatlerini çeken bir şey olup olmadığı soruldu. Birden fazla kişinin andığı ses özellikleri neredeyse yalnızca ikiydi: 21 kişi (yüzde 15) bath türü kelimelerdeki farklı "a"dan, 22 kişi (yüzde 16) yutulan "r"lerden söz etti. Makaleye göre bunlar, Amerikalıların zaten iyi tanıdığı ve toplumsal anlam yüklediği aksan özellikleri.
Araştırmacılar bir adım ileri gitti ve bu sesleri fark ettiğini yazanlarla yazmayanları karşılaştırdı. Fark edenler, taklit grubunda o sesi daha güçlü taklit etmişti. Talimat almayan grupta da fark edenlerin yaklaşması istatistik olarak anlamlıydı, fark etmeyenlerinki ise sınırda kaldı. Yazarlar bu analizi önceden planlanmamış, keşif amaçlı bir inceleme olarak niteliyor.
Beklenti kulağı bastırınca
Çalışmanın belki en ilginç ayrıntısı trap sesinde çıktı. Amerikalıların çoğu bath ile trap kelimelerindeki "a"yı aynı ses olarak söylüyor; Avustralyalı konuşmacı ise ikisini ayırıyor: bath'ı geride, trap'i biraz önde söylüyor. Taklit grubundakiler deneyin başında konuşmacının trap sesine doğru açıkça kaydı; ancak kelimeler ilerledikçe bu kayma eridi. Makaledeki ölçüme göre fark, ilk tekrarlarda yaklaşık 100 hertz iken son tekrarlarda 20 hertz civarına indi.
Yazarların yorumu şu: Katılımcılar zamanla zihinlerinde "bu kadın 'a'ları geride söylüyor" diye bir konuşmacı resmi kurdu. Kendi dillerinde tek ses olan bath ile trap aynı kalıba girince, az önce kulaklarına gelen öndeki trap sesi bu genel resmin altında kaldı. Campbell-Kibler bunu şöyle anlatıyor: "Onun genelde nasıl konuştuğunu düşündüğünüz şey, az önce duyduğunuz sesi ezip geçiyor."
Saygın aksanı taklit etmek kolay
Araştırmacılar Avustralya İngilizcesini bilerek seçti: Önceki araştırmalara göre Amerikalılar bu konuşma biçimine genelde olumlu bakıyor. Campbell-Kibler'e göre bu, katılımcıların rahat taklit etmesini de açıklıyor olabilir; çünkü bu durumda insan, damgalanmış bir grubun konuşmasını taklit ederken olabileceği gibi "birisiyle dalga geçiyormuş" duygusuna kapılmıyor. Makalenin andığı önceki çalışmalarda da olumsuz kalıp yargılarla anılan ağızların özelliklerinin daha az taklit edildiği görülmüştü.
Bu nokta Türkçe konuşan okura da tanıdık gelebilir. Bir şiveyi taklit etmek bazen sevgi dolu bir şaka, bazen kırıcı bir alay gibi algılanabiliyor; insan kimin yanında, kimin şivesini taklit ettiğine dikkat ediyor. Ancak çalışma Türkçe ya da Türkiye'deki ağızlarla yapılmadı; aynı sonucun daha az itibar gören bir aksanda da çıkıp çıkmayacağı bu deneyden bilinmiyor.
Bulgunun sınırları
- Gerçek sohbet değil: Katılımcılar bir insanla konuşmadı, kulaklıktan gelen tek tek kelimeleri tekrar etti. Günlük hayattaki karşılıklı konuşmada denetimin ne kadar sürdüğü ayrı bir soru.
- Tek konuşmacı, tek yön: Bütün sesler tek bir Avustralyalı kadından geldi ve yalnızca Amerikalıların Avustralya aksanını taklidine bakıldı. Beş ses grubu ve her birinde sekiz kelime incelendi.
- Örneklem: Katılımcılar bir bilim müzesinin ziyaretçileriydi; 136 kişinin 115'i kendini beyaz olarak tanımladı.
- Önceki sonuçla çelişki: Aynı konuşmacı ve benzer bir katılımcı kitlesiyle yapılan 2015 çalışmasında, taklit etmemesi söylenen insanlar da konuşmacıya benzemişti. O deneyde katılımcılara bir lehçe tanıma çalışmasında oldukları söylenmiş ve birden fazla konuşmacı dinletilmişti. Yazarlar farkın nedenini kesin olarak gösteremediklerini yazıyor.
- Belirsiz ayrıntılar: kit sesindeki uzaklaşmanın tesadüf olabileceğini yazarlar kendileri belirtiyor. Kadınların erkeklere göre biraz daha fazla yaklaştığı görüldü, ancak yazarlar bunun ne anlama geldiğinin açık olmadığını vurguluyor.
- Otomatik mi, oyun mu? Talimat almayan gruptaki "r" taklidinin kendiliğinden bir refleks mi, yoksa katılımcıların eğlenmek için bilerek yaptığı bir "dil oyunu" mu olduğunu deney ayıramıyor; yazarlara göre ikisinin karışımı da olabilir.
Memlekette geri gelen şive
Campbell-Kibler, aksan kapmanın dilbilimciler için hâlâ büyük bir soru işareti olduğunu söylüyor: "Neden herkesin aksanını kapmıyoruz?" Verdiği örnekler tanıdık: Eşler on yıllarca birlikte yaşasa da birbirinin aynısı gibi konuşmaya başlamıyor; çocuklukta konuşulan ağız ise en çok aileyle konuşurken ortaya çıkıyor. Ona göre yeni bir bölgeye taşınan insanlar da çoğu zaman geldikleri yer ile yaşadıkları yer arasında, "ortada bir yerde" duran bir aksana varıyor.
Bu deney, bayramda memlekete dönen birinin şivesini doğrudan ölçmedi. Ama o sahneye bakmak için bir pencere açıyor: Benzeşme ne tamamen kendiliğinden ne de tamamen bilinçli; insan, isterse kendi konuşmasını büyük ölçüde koruyabiliyor, istemediğinde ise kulağına en çok çarpan, en "anlamlı" bulduğu sesleri kapıyor.
Campbell-Kibler bundan sonra otomatik taklit ile bilinçli dil oyununu birbirinden ayırmaya çalışmak istiyor. Açık soru da tam orada duruyor: Sohbette karşımızdakine benzediğimiz anlar, beynin kendiliğinden işleyen bir mekanizması mı, yoksa çoğu zaman farkında olmadan yaptığımız küçük bir tercih mi?
Fotoğraf: Ananian, CC BY-SA 3.0, Wikimedia Commons